随着企业信息化建设的深入,数据源类型不断丰富,数据库文件类型日趋多样,传统的SQL查询与数据处理方式正面临前所未有的挑战。本文围绕“数据源类型+1、数据库文件类型+2、SQL查询升级点+n、数据处理”这一主题,探讨如何构建更加高效、灵活的数据处理体系。
一、数据源类型+1:扩展数据接入能力
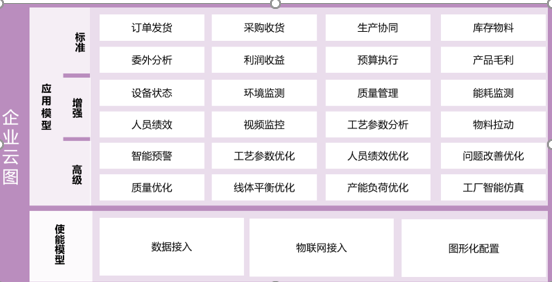
传统数据处理主要依赖关系型数据库,而现代业务场景中,数据源类型已扩展至NoSQL数据库、消息队列、REST API、文件系统、物联网设备等。所谓“数据源类型+1”,即是在现有支持的数据源基础上,新增一种或多种数据源接入能力。例如,在原有关系型数据库和文件系统的基础上,增加对Kafka流式数据源的支持。这一扩展要求数据处理平台具备统一的接入层,通过抽象数据源接口,实现新数据源的快速适配,同时保证数据一致性与实时性。
二、数据库文件类型+2:兼容多样存储格式
数据库文件类型不仅包括传统的CSV、JSON、XML,还涵盖Parquet、ORC、Avro等列式或行式二进制格式。提出“数据库文件类型+2”,意味着在现有文件类型支持基础上,至少新增两种格式的读写能力。例如,在仅支持CSV和JSON的基础上,增加对Parquet和ORC的支持。这需要升级文件解析引擎,引入相应的序列化/反序列化库,并优化I/O性能。针对不同文件类型的特点(如Parquet的列式存储优势),应设计智能选择策略,在查询时自动选取最优文件格式,减少数据扫描量。
三、SQL查询升级点+n:多维度的查询能力提升
“SQL查询升级点+n”代表了在SQL查询层面进行多项增强。升级点可包括:
- 联邦查询:支持跨多种数据源和文件类型的统一SQL查询,无需数据搬运即可实现联合分析。
- 向量化执行:利用CPU的SIMD指令,大幅提升查询执行效率。
- 自适应查询优化:基于统计信息和运行时反馈,动态调整执行计划。
- 半结构化数据查询:提供对JSON、XML等嵌套数据的原生SQL支持。
- 流批一体查询:统一流处理和批处理的SQL语义,简化开发。
- 智能索引推荐:根据查询负载自动推荐并创建索引。
以上升级点可根据实际需求选取“n”项进行组合实施,形成适合业务场景的SQL查询增强方案。
四、数据处理:构建端到端的数据流水线
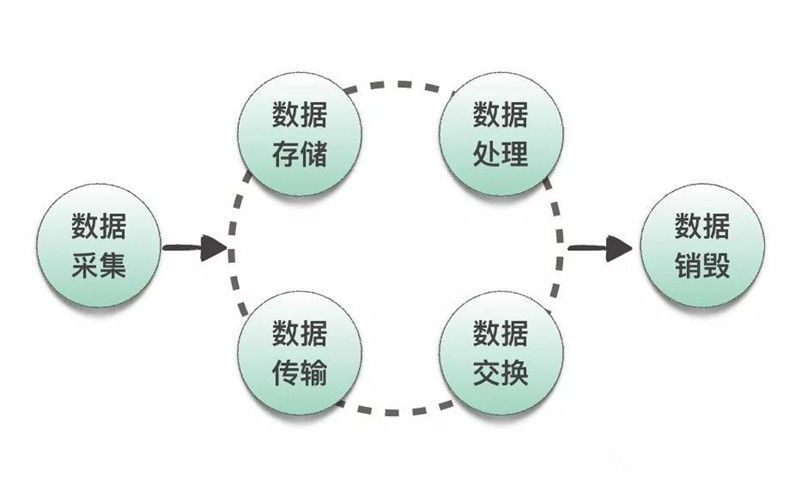
数据处理是上述能力的最终落地环节。结合多源数据接入、多格式文件兼容和SQL查询升级,数据处理流程应实现:
- 数据抽取:从新型数据源和新增文件类型中高效抽取数据。
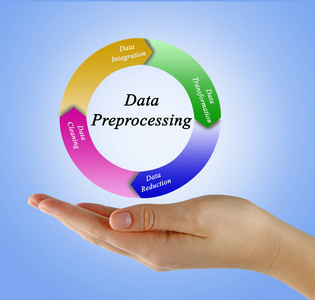
- 数据清洗与转换:利用增强的SQL能力进行复杂清洗、转换和聚合。
- 数据加载:将处理结果写入目标存储,支持多种文件类型输出。
- 任务调度与监控:通过工作流引擎编排数据处理任务,并实时监控数据质量与性能。
五、
通过“数据源类型+1”扩展接入边界,“数据库文件类型+2”提升存储兼容性,“SQL查询升级点+n”强化查询分析能力,最终在数据处理环节实现端到端的优化,企业可以构建一个更加开放、高效、智能的数据处理平台,从容应对大数据时代的多样性与实时性需求。